

「AIが最も引用しているサイトはWikipediaだ」
この一文を、2026年に入ってから何度か目にした方は多いと思います。実際、そう報じた調査は複数あります。一方で、ほぼ同じ時期に「Wikipediaは主要な引用元ではない」と結論づけた調査も公開されています。
同じWikipediaという対象について、公開されているシェアの数字は 0.39%から47.9%まで、100倍以上の幅 で流通しています。どれも捏造ではありません。すべて実測値です。
本記事では、この食い違いがなぜ起きるのかを分解したうえで、海外のGEO調査を自社の施策判断に使うために何を確認すべきかを整理します。あわせて、ギャプライズが自社のAI検索対策をAthenaHQで計測した実データを開示し、その自社データにも同じ落とし穴が4つあったことまで公開します。
目次
この記事の要点
-
- AI引用元の数字が食い違う原因は「指標の定義」「計測期間」「プロンプト集合(母集団)」の3つで、どれが効いているかは比較する組み合わせごとに違う
- 海外調査から転用できるのは順位や比率ではなく、「引用されるページの構造」に関する知見である
- ギャプライズの実測(日本語プロンプト38件・2,439レスポンス)では、日本語版Wikipediaは上位1,000ドメインに一度も出現しなかった
- 自社データにも「期間」「母集団」「指標」「ツール設定」の4つの歪みがあり、それを確認せずに読むと結論が変わる
AIが最も引用しているサイトは、結局どこなのか?
単一の答えは存在しません。
調査ごとに「どのAIを」「いつ」「どんな質問文で」「何を分母にして」測ったかが違うため、順位も比率も変わります。同じドメインについて、桁の違う数字が同時に正しいという状態が普通に起こります。
Wikipediaを例に、公開されている数字を並べてみます。
| 出典 | Wikipediaの数字 | 何を測ったか |
| Profound | 47.9% | ChatGPTの上位10ドメイン内でのシェア |
| Profound | 7.8% | 総引用数に占めるシェア(ChatGPT) |
| Profound | 2.49% | Wikipediaを引用した回答の割合 |
| Limy | 0.96% | 総引用数に占めるシェア(OpenAI) |
| Limy | 0.39% | 総引用数に占めるシェア(5エンジン合計) |
上の3つは、すべて同じProfoundの調査から出ている数字です。6億8,000万件の引用を対象に、2024年8月から2025年6月にかけて計測されたもので、47.9%は「上位10ソースの中でのシェア」であり「回答の半分がWikipedia由来」という意味ではありません。
つまり、ある数字を見たときに最初に確認すべきは順位ではなく、その数字の分母が何かです。
なぜ同じ調査から3つの数字が出るのか?
指標の定義が違うためです。
AI検索の世界で「引用率」と呼ばれるものには、少なくとも3種類あります。分母が違えば、同じ現象を測っても数字は数倍から数十倍変わります。
| 指標 | 計算式 | 性質 |
| 上位内シェア | そのドメインの引用数 ÷ 上位10ドメインの引用数 | 最も大きく出る。上位が寡占なら跳ね上がる |
| 引用シェア(citation share) | そのドメインの引用数 ÷ 全引用数 | 総量に対する比率。ロングテールが厚いと小さくなる |
| 出現率(response presence) | そのドメインが登場した回答数 ÷ 全回答数 | 「何回に1回顔を出すか」。1回答内で何度引用されても1と数える |
Profoundの3つの数字は、この3指標をそのまま並べたものです。47.9%(上位内シェア)、7.8%(引用シェア)、2.49%(出現率)。同じ実測データから、同じドメインについて、20倍近い差が生まれています。
厄介なのは、これらがどれも日本語では「引用率」と訳されがちなことです。記事やレポートで数字を引用するときは、元の英語表記と分母まで確認する必要があります。
なお、引用率と言及率(Mention Rate)の違いについては別記事で整理しています。
Limyの0.39%は、何を測った数字なのか?
AI可視性計測ツールLimyが、同社の顧客企業977アカウントの計測結果を集計した引用シェアです。 対象は5つのAIプロバイダ、約76億件の引用、期間は2025年5月から2026年8月。Wikipediaは全引用の0.39%、およそ258件に1件という比率でした。
同社はこの結果から、Wikipediaは生成AIの主要な引用元とは言えないと結論づけています。直近12か月で1.46%から0.22%へ、およそ6分の1に減少したことも示されています。
ここで重要なのは、977アカウントというのが「Web全体」ではなく「Limyの顧客企業」であるという点です。ギャプライズからの問い合わせに対し、Limy社は次のように回答しています。
アカウントの多くはBtoB SaaS、金融サービス、ヘルスケア、旅行、保険といった業種に属しており、EC(コマース)や一般的なBtoC ブランドに特化した構成ではない。プロンプトの約75%は英語で、米国・英国・オーストラリアなどの市場にまたがる。
つまりこの数字は、BtoB寄りの企業が自社ブランドを追跡するために設計したプロンプト群を通して見た世界です。Limy自身のデータでも、商用プロンプトでのWikipedia比率は0.366%と、一般プロンプト(0.450%)や情報系プロンプト(0.421%)より低く出ています。
「AIに聞いたときのおすすめツールは?」という質問と、「アインシュタインとは誰か」という質問では、AIが参照する情報源が違って当然です。前者に偏った母集団でWikipediaの比率を測れば、低く出ます。これは調査の欠陥ではなく、測定目的に沿った設計の結果です。
同じ会社の別調査は、母集団が200分の1
母集団が調査ごとに設計されるものだという点は、Limyの別の調査を見るとより鮮明です。同社が2026年8月に公開したReddit引用の分析は、5アカウント・50万3,152引用・3プロバイダを対象としています。
| Wikipedia調査 | Reddit調査 | |
| 対象アカウント | 977 | 5 |
| 引用数 | 約76億 | 50万3,152 |
| 期間 | 2025年5月〜2026年8月 | 2025年8月〜2026年7月 |
| プロバイダ | 5 | 3 |
アカウント数で約200倍の開きがあります。これは一方が雑だということではなく、問いが違えば必要な母集団も違うということです。ドメイン全体の比率を見るには広いデータが要り、引用されたページの中身を1件ずつ人手で読むなら200件が現実的な上限になります。
読み手の側は、「大規模だから信頼できる」ではなく「その規模は、その問いに対して適切か」を見る必要があります。
引用元は、時期によって変わるのか?
変わります。しかも短期間で大きく動きます。
Limyのデータでは、OpenAIにおけるWikipediaの引用シェアは5.32%から0.29%へ、およそ18分の1に低下しています。他の4エンジンは0.1〜0.5%の範囲でほぼ横ばいであり、全体の下落はOpenAI単独の動きによるものでした。
ここで、先ほどのProfoundの数字と時期を並べてみます。
| 調査 | 計測期間 | Wikipediaの引用シェア |
| Profound | 2024年8月〜2025年6月 | 7.8%(ChatGPT) |
| Limy | 2025年5月〜2026年8月 | 期首5.32% → 期末0.29%(OpenAI) |
2つの調査は、ほとんど期間が重なっていません。
そしてLimyの計測開始時点の値(5.32%)は、直前まで計測していたProfoundの7.8%と、桁として矛盾しません。
「7.8%」と「0.29%」は対立する主張ではなく、同じ下降トレンドの別の断面を見ている可能性が高いということです。公開された時点だけを見て新旧のデータを突き合わせると、この構造は見えません。
一方で、時期だけですべてが説明できるわけでもありません。2026年半ば時点の別のトラッカーではWikipediaが依然として上位に位置しており、Limyの同時期の数値とは重なりません。この組み合わせでは、期間ではなくプロンプト集合の差が効いていると考えるのが自然です。
要因は3つあり、どれが効いているかは比較する組み合わせごとに違う。ここを一律に説明しようとすると、必ずどこかで無理が出ます。
その数字は、日本市場に当てはまるのか?
当てはまりません。
ギャプライズからの問い合わせに対し、Limy社は同調査における日本の位置づけを次のように回答しています。
日本とAPACのデータはいずれも保有しているが、日本は全引用の1%未満、APAC全体でおよそ6%にとどまる。日本またはAPAC単独の詳細分析は未実施であり、より細かい内訳を提供する前にデータの頑健性を検証したい。
約76億件という規模は圧倒的ですが、そのうち日本由来は1%未満です。サンプルの絶対量が大きいことと、自社の市場に当てはまることは別の話だという、単純ですが見落とされやすい事実がここにあります。
なお、Limy社が「データの頑健性を確認してから」として安易な国別内訳を出さなかった姿勢は、調査提供者として誠実なものだと考えます。数字を出せる状態と、出してよい状態は違います。
日本語プロンプトで測ると、日本語版Wikipediaは出てこない
では日本ではどうなのか。ギャプライズが自社のAI検索対策をAthenaHQで計測した実データを開示します。
| 項目 | 内容 |
| プロンプト数 | 38件(非指名32件/指名6件) |
| 対象エンジン | ChatGPT / Gemini / Copilot / AI Overview の4種 |
| 総レスポンス数 | 2,439件(うち関連1,466件) |
| 計測日 | 2026年3月25日〜30日 |
| 言語・テーマ | 日本語/GEO・AI検索対策ツールの探索と比較 |
この計測で出現した上位1,000ドメインを確認したところ、結果は次のようになりました。
| ドメイン | 順位 | 出現率 |
| ja.wikipedia.org | 上位1,000位以内に出現せず | — |
| en.wikipedia.org | 63位 | 2.01% |
日本語のプロンプトを日本語圏向けに回しているにもかかわらず、日本語版Wikipediaは一度も引用元として現れませんでした。 英語版が63位に留まります。
一般消費者向けの幅広いクエリを対象とした調査では、日本語版WikipediaがAI引用元の上位に入るという結果が報告されています。それらの調査と本計測は、同じ日本市場を対象としながら、逆の結論を示しています。
これは、どちらかが間違っているという話ではありません。問いが違えば、AIが参照する情報源も変わるというだけのことです。「〇〇とは何か」を尋ねればWikipediaが出てきますが、「BtoB向けのGEOツールを比較してください」と尋ねれば、AIは百科事典を見に行きません。
海外調査であれ国内調査であれ、他社が設計したプロンプト集合の結果は、自社の顧客が実際に打つ質問文とは別物です。
では、海外の調査から何を持ち帰るべきなのか?
ランキングではなく、構造です。
「どのドメインが何%」という比率は母集団に強く依存するため他市場に転用できませんが、「AIはどういう形のページを引用するのか」という構造的な知見は、転用できる可能性があります。
Limyが公開したReddit引用の分析は、後者の典型です。同社はAIエンジンに引用された200件のReddit URLを人手で分類し、次の傾向を報告しています。
-
- 引用されたスレッドの79%が、質問と回答の構造を持っていた
- 被引用投稿のupvote中央値は11。40%は10未満で、6%はゼロだった
- 80%の投稿はupvoteよりコメント数が多く、コメント数の中央値は33
- 投稿の年齢は7日から14年まで分布し、中央値は2年。新しさは要件ではない
- サブレディットの規模は週間訪問65から380万まで全域に分布し、規模も要件ではない
- 本文が削除された投稿、本文が印刷物の写真しかない投稿も、タイトルとコメントが残っていれば引用されていた
要約すると、評価スコアでも、新しさでも、コミュニティの規模でもなく、「質問形式のタイトル」と「その下に具体的な答えがあること」が引用の条件だった、ということです。
この知見は、Redditというプラットフォームに依存していません。日本でRedditの利用者が少ないことは、この構造が日本で成立しないことを意味しません。
日本でも、同じ構造は成立するのか?
成立します。
ギャプライズのサービスサイトを対象にした実測データでも、引用の集まり方はLimyの観測と一致しました。
まず、日本語のBtoBプロンプトでもRedditは引用されています。
| ドメイン | 順位 | 出現率 | 被引用URL数 |
| prtimes.jp | 1 | 13.98% | 100 |
| note.com | 2 | 13.49% | 107 |
| reddit.com | 6 | 9.72% | 133(全ドメイン中最多) |
| youtube.com | 7 | 9.51% | 2 |
日本語の質問に対しても、reddit.comは6位に入り、被引用URL数では1,000ドメイン中で最多でした。
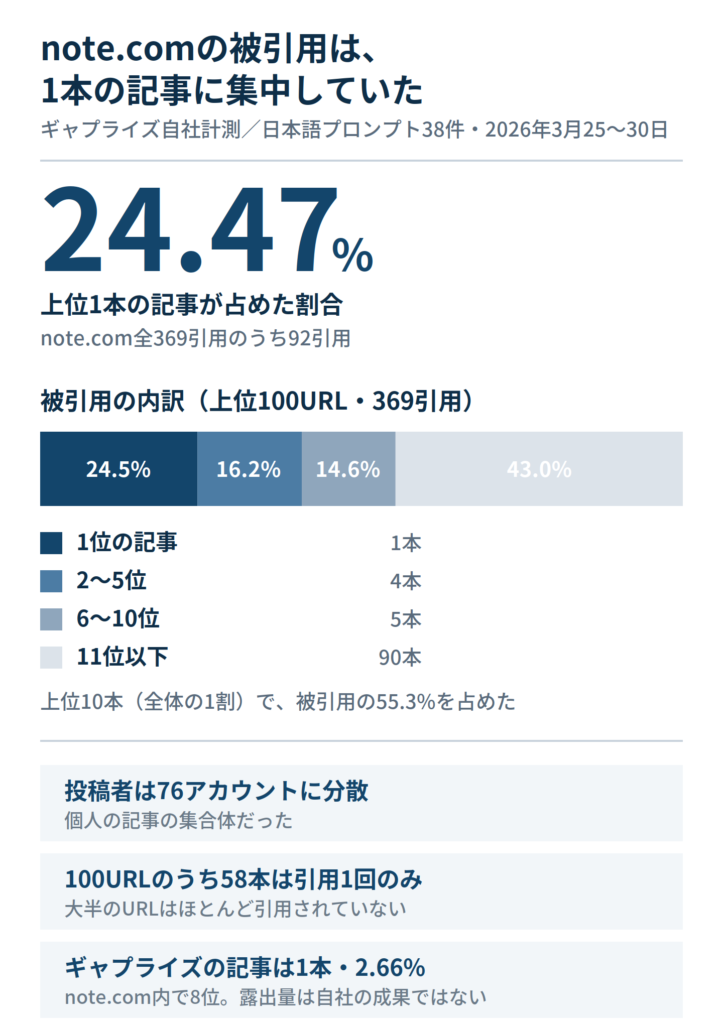
さらに示唆的なのは、上位に入った日本語プラットフォームの中身です。note.comの被引用URLを上位100件分解したところ、投稿者は76アカウントに分散していました。企業のオウンドメディアではなく、個人が書いた記事の集合体です。
そして、そのうち1本の記事が、note.com全体の被引用の24.47%を占めていました(100URL・369引用中92引用)。上位5URLで40.7%、上位10URLで55.3%。残る58URLは引用1回のみです。
この1本がどんな記事かというと、GEOツールを価格帯別に比較し、月額いくらのツールがどんな規模の企業に向くかまで具体的に書いた比較記事でした。質問に対する直接的な答えがあり、固有名詞と数字が入っている。 Limyが200件のReddit投稿から抽出した特徴と、まったく同じ形をしています。
プラットフォームはRedditからnoteに変わり、言語も英語から日本語に変わっていますが、引用されるページの形は変わっていません。 海外調査から持ち帰るべきものが構造である、というのはこういう意味です。
引用のされ方には、2つの型がある
同じ「上位ドメイン」でも、少数のURLが繰り返し引用される型と、多数のURLが薄く広く引用される型があります。 被引用URL数とレスポンス数を並べると、この差がはっきり出ます。
| ドメイン | 出現率 | 被引用URL数 | 1URLあたりのレスポンス数 |
| pascaljp.com | 12.59% | 2 | 153.5 |
| youtube.com | 9.51% | 2 | 116.0 |
| hubspot.jp | 9.47% | 11 | 21.0 |
| prtimes.jp | 13.98% | 100 | 3.4 |
| note.com | 13.49% | 107 | 3.1 |
| reddit.com | 9.72% | 133 | 1.8 |
上の2つは、たった2本のURLで300件近い回答に登場しています。一方でreddit.comは133本のURLを動員して237件です。ドメインとしての露出量は近くても、成り立ちがまったく違います。
この違いは、施策の設計に直結します。
- 少数集中型を狙うなら、1本の記事を徹底的に作り込む。比較・価格・推奨といった「答えそのもの」を含む決定版を1本置く方が効率がよい
- 分散型が優勢な領域なら、量とテーマの広がりが効く。ただし1本あたりの寄与は小さく、ロングテールを積む発想が必要になる
自社のテーマがどちらの型なのかは、実際に計測してみないと分かりません。そして、その判断材料は他社の調査には載っていません。
自社データにも、同じ落とし穴があった
ここまで他社調査の読み方を論じてきましたが、同じ問題は自社の計測にも起きます。 上で使ったギャプライズのデータを解剖したところ、4つの歪みが見つかりました。隠さずに開示します。
落とし穴1:期間表記と、実際にデータがある期間が違う
エクスポートされたレポートのヘッダーには、対象期間として「2026年2月1日〜5月31日」と記載されていました。4か月間の調査に見えます。
しかし日次データを開くと、レスポンスが記録されているのは3月25日から30日までの6日間だけで、他の日はすべてゼロでした。2,439件はこの6日間に集中しています。
この記事で「2026年2月〜5月の調査」と書けば、それは事実上の誤りになります。ツールが出力した期間表記を、そのまま調査期間として転記してはいけません。
落とし穴2:競合が上位に来たのは、こちらがそう質問したから
計測に使った38件のプロンプトのうち、6件は競合名を明示的に含む指名プロンプトでした。「AthenaHQと〇〇の違いを教えてください」といった形式です。
結果として、集計上は競合各社のドメインが上位に並びました。しかしこれは市場での実力ではなく、こちらの質問設計が作り出した数字です。名前を出して聞けば、AIはその会社のサイトを参照します。
トピック別の数字が、この影響の大きさを示しています。
| トピック | プロンプト数 | 自社のシェア・オブ・ボイス |
| 競合名指し比較(指名) | 5 | 51.1% |
| サポート比較 | 3 | 18.2% |
| 導入難易度比較 | 5 | 8.6% |
| 機能・性能比較 | 10 | 6.3% |
| ツール探索 | 10 | 3.7% |
同じ計測結果の中に、3.7%と51.1%が同居しています。
どちらを切り出すかで「自社は強い」とも「弱い」とも書けてしまう。社内報告で数字を出すときに、最も注意すべき点です。
実務的には、指名プロンプトと非指名プロンプトは分けて見るべきです。買い手が自社を知らない段階での露出を測りたいなら、見るべきは非指名側の3.7%の方です。
落とし穴3:ツールの「Citation %」は引用シェアではなかった
AthenaHQが出力する Citation % を検証しました。各ドメインのレスポンス数をこの値で割ると、すべての行で母数が2,439に収束します。また1,000ドメイン分を合計すると676%になり、100%を大きく超えます。
つまりこの指標は、「総引用数に占めるシェア」ではなく「そのドメインが登場した回答の割合」、この記事の前半で整理した3分類でいう出現率です。
冒頭で扱ったLimyの0.39%は引用シェアでした。名前は似ていますが、分母が違います。 異なるツールやレポートの数字を並べて比較するときは、この確認を飛ばせません。
落とし穴4:ツールの設定が、数字の意味を変えていた
計測結果では、note.comが「owned(自社資産)」に分類されていました。この分類のまま読めば、「自社の露出がAI引用元の2位」という結論になります。
しかし内訳を開いたところ、上位100URLの投稿者は76アカウントに分散しており、ギャプライズのアカウントによる記事は1本、10引用のみでした。note.com内でのシェアは2.66%、8位です。
ドメイン単位でownedを登録した設定が、他者の記事99本を自社資産として集計していたわけです。設定を確認せずに数字を読めば、自社の可視性を10倍以上に過大評価することになります。
ツールが出す数字は、ツールの設定を反映しています。
設定は自分たちが作ったものであり、点検の対象です。
実務では、何を確認すればよいのか?
AI検索に関する調査データを自社の判断材料にする前に、次の5点を確認することをおすすめします。このうち1つでも不明なら、その数字は参考値として扱うべきです。
| 確認項目 | 確認しないと起きること | |
| 1 | 分母は何か(上位内シェア/引用シェア/出現率) | 桁の違う数字を同列に比較してしまう |
| 2 | 実際にデータがある期間はいつか | 表記上の期間と実測期間の差を見落とす |
| 3 | どんなプロンプト集合か(指名/非指名、業種、言語) | 他社の顧客の質問文を、自社の判断根拠にしてしまう |
| 4 | 言語と地域の構成比 | 日本が1%未満のデータを日本市場の根拠にしてしまう |
| 5 | ツール側の分類・設定はどうなっているか | 他社の資産を自社の成果として数えてしまう |
そのうえで、より本質的な結論を1つ。
他社の調査は仮説を得るためのものであり、自社の意思決定の根拠にはなりません。
引用されるページの構造のような転用可能な知見は他社調査から学べますが、「自社のテーマで、自社の買い手が打つ質問文に対して、いま誰が引用されているか」は、自社で測る以外に知る方法がありません。
そして測ったあとには、もう一段の問いが残ります。AIの回答に登場し、そこからサイトに来た人が、実際に何をして、どこで離脱したのか。入口の可視性と、その後の行動は別の指標です。
まとめ
-
- AI引用元に関する数字の食い違いは、「指標の定義」「計測期間」「プロンプト集合」の3要因で説明できる。どれが効いているかは比較する組み合わせごとに違う
- 同じProfoundの調査から47.9%・7.8%・2.49%という3つの数字が出るように、分母を確認せずに順位を比較しても意味がない
- 海外調査から転用できるのは順位ではなく構造である。質問形式のタイトルと具体的な答えを持つページが引用されるという傾向は、Redditでもnoteでも、英語でも日本語でも共通して観測された
- 自社の計測データにも、期間・母集団・指標・設定という4つの歪みが存在する。他社データを疑うのと同じ厳しさで、自社データも点検する必要がある
AI検索での自社の見え方を測ることは、いまや難しくありません。まずは自社の買い手が実際に打ちそうな質問文を10件書き出し、主要なAIに投げてみるところからで十分です。自社が挙がらない、あるいは競合ばかりが並ぶとしたら、それが現在地です。
その先——計測の仕組み化、指名と非指名の切り分け、来訪後の行動分析まで踏み込む段階でリソースや知見の壁にぶつかったら、ぜひご相談ください。ギャプライズでは、AI検索での可視性計測(AthenaHQ)から、AI経由で来訪したユーザーの行動可視化(Contentsquare)まで、海外で実績のあるソリューションを国内で提供しています。
よくある質問(FAQ)
AIの引用元ランキングは、なぜ調査によって順位が違うのですか?
指標の定義、計測期間、プロンプト集合(母集団)の3つが調査ごとに異なるためです。特に指標は「上位10ドメイン内でのシェア」「総引用数に占めるシェア」「そのドメインが登場した回答の割合」の3種類があり、同じデータでも20倍近い差が出ます。順位を比較する前に、分母が同じかどうかを確認してください。
海外のGEO調査は、日本市場の参考になりますか?
順位や比率は参考になりません。たとえばある大規模調査では、日本由来の引用は全体の1%未満でした。一方で「AIがどういう形のページを引用するか」という構造的な知見は、言語やプラットフォームを超えて共通する傾向が見られます。数字ではなく構造を持ち帰るのが実務的です。
日本語版WikipediaはAIに引用されるのですか?
対象とする質問文によって大きく変わります。一般的な知識を問うクエリを対象とした調査では上位に入る一方、ギャプライズがBtoB向けのツール比較プロンプト38件で計測した結果では、日本語版Wikipediaは上位1,000ドメインに一度も出現しませんでした。自社のテーマで測ることをおすすめします。
引用率と言及率は何が違いますか?
言及率はAIの回答本文で自社ブランドが触れられた割合、引用率は回答の出典・参照元として自社URLが挙げられた割合です。引用のほうが情報源として採用された状態であり、クリックにもつながりやすいため影響力は大きくなります。
自社でAI検索の可視性を測るには、何から始めればよいですか?
買い手が実際に打ちそうな質問文を書き出すところからです。このとき、自社名を含む指名プロンプトと、含まない非指名プロンプトを必ず分けてください。両者は結果がまったく異なり、混ぜて集計すると自社の可視性を過大評価することになります。
出典・参考
- Limy「Is Wikipedia a major source for LLMs?」(2026年8月13日/977アカウント・5プロバイダ・約76億引用・2025年5月〜2026年8月)https://limy.ai/blog/is-wikipedia-a-major-source-for-llms
- Limy「Which Reddit post does LLM cite?」(2026年8月4日/5アカウント・3プロバイダ・50万3,152引用・2025年8月〜2026年7月/被引用URL 200件を人手分類)https://limy.ai/blog/which-reddit-post-does-llm-cite
- Profound「AI Platform Citation Patterns」(6億8,000万引用・2024年8月〜2025年6月)https://www.tryprofound.com/blog/ai-platform-citation-patterns
- ギャプライズ自社計測(AthenaHQ/日本語プロンプト38件・4エンジン・2,439レスポンス・2026年3月25日〜30日)
Limy社の調査データに関する母集団・指標・地域構成については、同社への問い合わせに対する回答を本文に反映しています。データの提供と確認にご協力いただいたLimy社に感謝します。